
前言
AI 项目从实验走向落地,绕不开算力这道坎。自己买卡的话,卡价、供电、散热都是问题,那么租 GPU 服务器就成了多数团队更现实的选择。但 GPU 服务器的租用和普通 VPS 不是一回事:参数维度更多、价格跨度更大,参数没核清楚就下单,轻则钱花了算力不够用,重则项目卡在半路等机器。本文就把要核对的事项整理成一份清单,按我们实际用下来的经验排了优先级,下单前对着过一遍,能避开大部分坑。
卡型要标明
先看商家敢不敢把卡型写明白。GPU 服务器页面上最常见的模糊话术是"旗舰级"“4090同级”,这类说法是没法核对的。
正经商家会把具体卡型列出来,而且不同卡型的定位差别也很大,不能只看型号数字大小。
举个例子:知名云厂商 VMRack 的 GPU 算力租用把卡型分了五档,每一档的定位和应用场景都写得明明白白:
H100 是成熟通用的高性能卡,训练、微调、推理、科学计算都能干,单卡就能起租;
H200 主打大显存高带宽,大型模型、长上下文、显存密集型任务找它;
B100、B200 是新一代 Blackwell,多卡、整机起步;
B300 定位下一代旗舰,整机、集群、定制方案。
卡型定位清晰,后面每一项核对起来才有依据。
显存决定模型装不装得下
显存是第一硬指标:模型装不装得下,先看显存。模型参数要占显存,推理时的 KV cache(长上下文对话时缓存的历史计算结果)也要占,长上下文应用对显存的要求会明显放大。量化可以压缩显存需求,但不是无代价——精度损耗和框架支持都要提前验证。
所以核对显存不只是看一个数字:模型多大、上下文多长、并发多少,这三个数先在本地估一遍,再对照商家给的显存去挑档位,而不是反过来。
数据盘别拖显卡后腿
训练和推理都吃数据吞吐,数据集的加载速度决定 GPU 吃不吃得饱,盘慢了显卡就在空转。NVMe 和 SATA SSD 的差距在日常业务体感上是数量级的,GPU 场景下这块预算别省。至于接口、随机 IO 这些盘的硬知识,可以参考 Alexander VPS 博客的这篇文章《裸金属服务器硬盘怎么选?SATA SSD和NVMe有什么区别》,写得比这篇细。
网络要看两头
两头指的是出站和卡间。出站带宽决定推理服务的访客体验,用户请求你的模型 API,带宽不够时再快的卡也吐不出结果;卡间互联决定多卡训练的效率,新一代卡型普遍多卡起步,多卡协同对内网互联的要求比对单卡跑分高得多。下单前这两头都要问清:出站带宽多少、是否独享,多卡机器的内网互联方案是什么。
计费方式和验证路径
GPU 租用的计费梯度一般是单卡、多卡、整机、集群,档位越高单价越低,但跳档意味着先把部署规模抬上去。我们的建议是别一步跳到最高档:先用低档短租验证——显存够不够、吞吐达不达标、软件栈顺不顺手,跑通了再按真实需求上量。
验证的思路和规模选档怎么定,可以参考 kenny 博客的这篇文章《B100 vs B300: Which Blackwell GPU Fits Your Workload?》,里面的规模选档思路和先短租验证再上量的路径讲得比较透。
软件栈和机房稳定性
软件栈容易被当成小事:CUDA 版本、驱动、镜像支持,新卡型的软件栈门槛比老卡高,团队若没有追新栈的经验,成熟卡型反而更省心。
机房层面看两点:
稳定性资质,Tier IV 认证的机房在供电、制冷这些底层保障上更让人放心;
防护能力,GPU 机器承载的往往是核心业务,被打了没人管就麻烦了。
总结
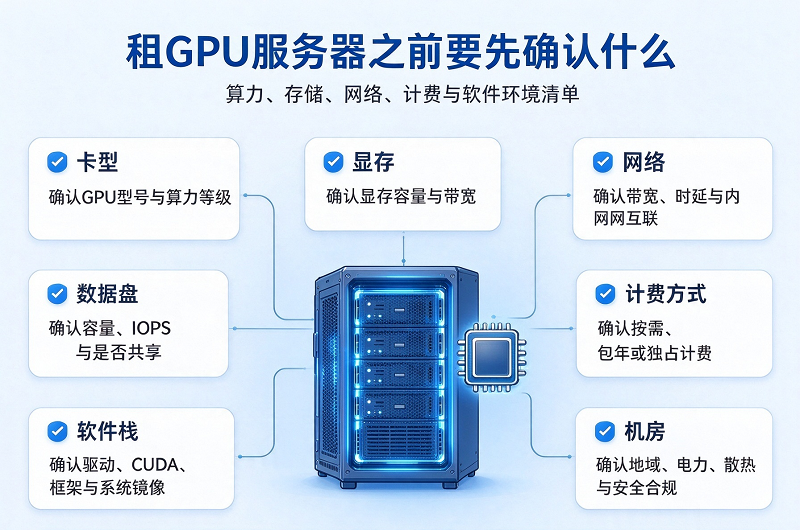
GPU 服务器的钱比 VPS 大得多,下单前的每一项核对都是在替项目省麻烦:
卡型要白纸黑字
显存对着业务需求算
数据盘和网络的短板会直接吃掉显卡的性能
计费从低档验证起步
软件栈和机房资质兜底。
按这份清单过一遍,再把参数落到合同或产品页上,GPU 这笔算力投入才算花得踏实。
评论区